机器学习进入合成实验室:把试错变成可搜索的配方空间
把配方编码成向量的方法、数据从实验还是计算来、闭环自主实验的组成,以及模型在什么情况下不该被相信。
材料合成的传统方式是改变一个变量、看结果,再改下一个。变量一多,组合数就爆炸。机器学习介入的价值不在于「更聪明」,而在于把有限的实验次数分配到最有可能的区域,并且让每次失败都变成对模型的修正。
一、先把配方变成可比较的数字
配方包含温度、时间、浓度、pH、配体等连续量,也包含溶剂种类、前驱体选择、晶面取向等类别量。前者可以直接归一化后送入模型,后者需要编码成向量或描述符。描述符的选择往往比模型结构更重要:若描述符无法反映前驱体分解路径的差别,再复杂的模型也只能学到噪声。近年来常用做法是引入化学先验——离子半径、电负性、溶解度——让描述符带上物理含义。
二、数据从哪里来
三条来源各有局限:文献提取的数据量大但实验条件不统一、结果口径杂乱;高通量自动实验数据一致性好,但设备能覆盖的变量范围窄;计算数据可以做到极大规模,但准确性依赖所选的理论方法。实践中通常把三者混合使用,先用计算或文献数据做预训练缩小搜索范围,再用自动化实验在局部做精细搜索。忽视数据一致性的做法会让模型记住实验批次差异,而不是化学规律。
三、
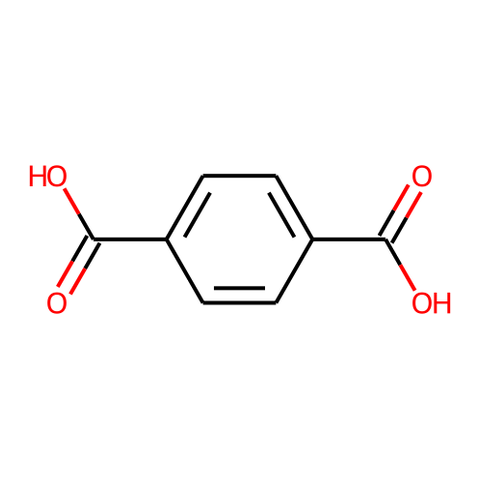
对苯二甲酸 · CAS 100-21-0
这类刚性双羧酸配体是构筑多孔框架材料的常用单元,也是机器学习辅助合成研究中出现频率很高的目标之一。这类反应的问题在于产物往往是多个相混合物:同一配方可能得到致密相、不同拓扑的框架相甚至无定形产物,产率与结晶度还依赖搅拌方式和升温速率。因此目标标签必须明确定义——是给出最高结晶度的配方,还是给出目标拓扑相比例最高的配方,两者的最优解完全不同。若标签定义模糊,模型给出的「最优配方」就无法复现。
四、闭环与自主实验
闭环系统由三部分组成:能自动配液与加热的合成平台、能快速表征产物的测试手段、以及根据结果更新模型的决策算法。其中真正的瓶颈通常在表征环节——若每个样品都需要数小时的结构解析,闭环的速度就无从谈起。因此实用系统会优先选择粉末衍射或光谱这类快速筛选手段做代理指标,再把少量最有价值的样品送去做精细表征。
五、模型什么时候不该被相信
当训练数据没有覆盖目标区域时,模型给出的预测只是外推。可靠的报告应包含不确定性估计,并且在每轮实验中有意识地留出一部分预算去探索预测不确定性最高的条件,而不是只挑预测值最好的点。缺少这一机制时,模型很快会收敛到局部最优,而研究者会把「没找到更好的」误认为「已经最优」。
文中重点试剂结构式 · 点击查看规格与价格
相关产品推荐正在从站内商品库匹配…
同一产品线更多文章
本文由本站编辑基于公开技术资料独立撰写,观点与表述仅代表本站;如需转载请与我们联系。文中产品参数、包装规格与价格以商品详情页为准,图片中的分子结构式由本站结构库按 CAS 生成,仅供识别参考。